Les Fondements Physiques de l’Intelligence Artificielle Locale
L’ère de l’intelligence artificielle générative a longtemps souffert d’une perception erronée : celle d’une immatérialité numérique, suspendue dans les infrastructures distantes du cloud. Pourtant, à mesure que l’impératif de confidentialité, la quête d’indépendance numérique et le désir d’immédiateté redéfinissent nos usages, le centre de gravité technologique opère un retour vers le matériel physique. Faire tourner un grand modèle de langage (LLM) au cœur même de sa propre machine ne relève plus de la simple expérimentation empirique ; c’est un acte d’architecture informatique exigeant une rigueur technique implacable sur les lois de la physique et de l’électronique.
Aborder le choix d’une configuration matérielle dédiée aux modèles neuronaux impose de dépasser les approches simplistes de la puissance brute. Ce n’est pas l’agitation stérile des téraflops qui dicte l’efficacité d’une inférence, mais la fluidité technique d’une circulation de données. Pénétrer dans l’intimité de ces architectures, c’est comprendre que chaque mot généré — chaque token — est le fruit d’un transfert massif à travers les circuits de la mémoire vive.
La Métrique de la Pensée : Débit, Latence et Ergonomie Cognitive
Pour juger de la pertinence d’un système, l’analyste ne saurait se contenter d’approximations. L’évaluation repose sur un triptyque impérieux :
- Le débit d’inférence, mesuré en tokens par seconde (tok/s) ;
- Le TTFT (Time To First Token), qui traduit le délai d’élaboration initiale du prompt ;
- La latence de chargement, s’intercalant entre l’impulsion et l’activation du modèle.
La perception humaine possède ses propres limites biologiques. Un lecteur aguerri parcourt entre 200 et 300 mots par minute, soit une cadence de 3,5 à 5 mots par seconde. Sachant qu’un millier de tokens équivaut grosso modo à 750 mots, le seuil de confort s’établit entre 4 et 6 tok/s pour une lecture en diagonale, tandis qu’un flux véritablement fluide s’établit au-delà de 10 à 15 tok/s. En deçà de 1 tok/s, le dialogue s’interrompt, se transformant en une attente excessive qui rompt le fil de l’analyse.
À titre comparatif, les infrastructures cloud affichent des vitesses élevées (50 à 80 tok/s), mais au prix d’une variabilité erratique dictée par la charge des serveurs partagés. En milieu local, la constance devient un atout majeur, à condition que le matériel soit dimensionné avec une précision absolue.
La Hiérarchie des Épreuves : De l’Efficience à la Monolithique Sagesse
L’évaluation empirique des architectures contemporaines s’articule autour de jalons rigoureux, éprouvant la résistance des machines face à des complexités textuelles croissantes :
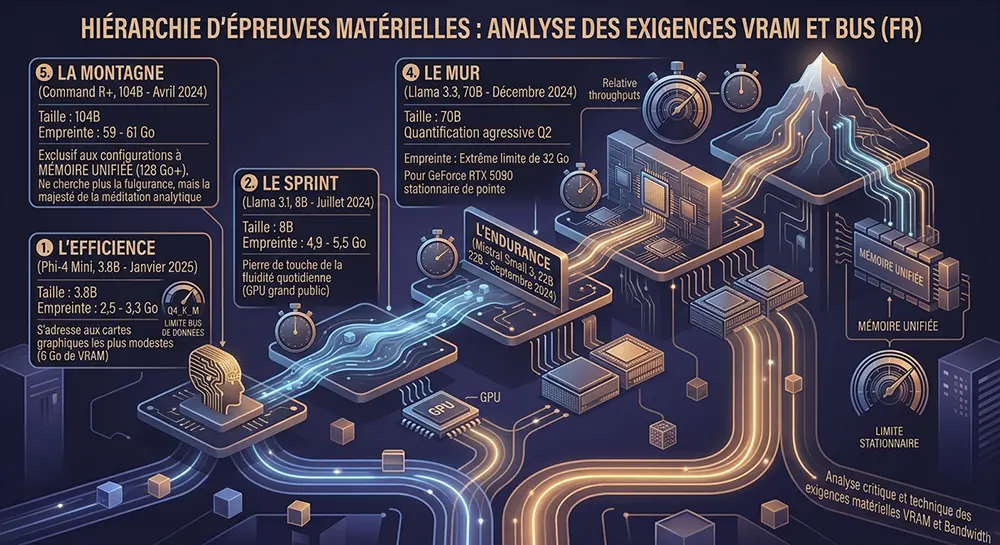
- L’Efficience (Phi-4 Mini, 3.8B - Janvier 2025) : Avec une empreinte oscillant entre 2,5 et 3,3 Go (quantification Q4_K_M), ce modèle éprouve les limites des bus de données et s’adresse aux cartes graphiques les plus modestes dotées de 6 Go de VRAM.
- Le Sprint (Llama 3.1, 8B - Juillet 2024) : Exigeant de 4,9 à 5,5 Go, il constitue la référence de la fluidité quotidienne pour une écrasante majorité de GPU grand public.
- L’Endurance (Mistral Small 3, 22B - Septembre 2024) : S’étirant de 12 à 13 Go (Q4_0), il dresse une frontière technique nette entre les cartes de 8 Go, vouées à la saturation, et celles de 16 Go qui disposent de marge.
- Le Mur (Llama 3.3, 70B - Décembre 2024) : Réduit à une quantification agressive de type Q2 pour s’intégrer dans les 32 Go d’une GeForce RTX 5090, il représente la limite opérationnelle du matériel grand public de pointe.
- La Montagne (Command R+, 104B - Avril 2024) : Exigeant de 59 à 61 Go, il demeure l’apanage exclusif des configurations à mémoire unifiée frôlant ou dépassant les 128 Go.
La Tyrannie de la Bande Passante : Pourquoi la VRAM Règne en Souveraine
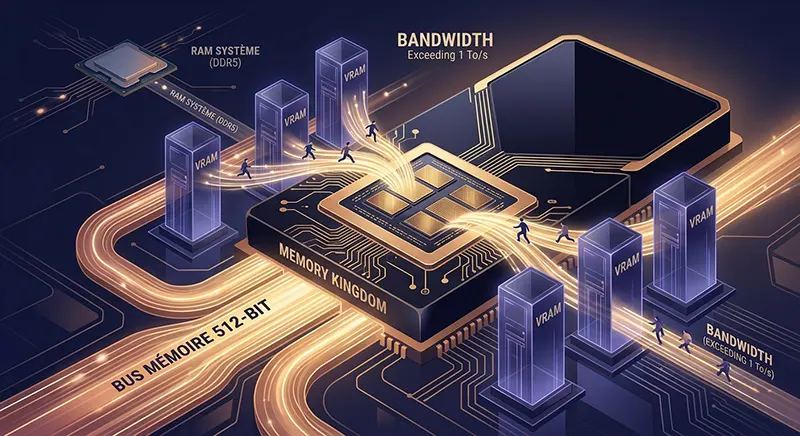
L’erreur technique du débutant consiste à privilégier uniquement le processeur graphique (GPU) au détriment de son sous-système mémoriel. Or, le fonctionnement interne d’un LLM est impitoyable : à chaque token produit, l’algorithme doit relire l’intégralité des paramètres du modèle. Pour un modèle de 8 milliards de paramètres quantifié en 4 bits, ce sont environ 5 Go de données qui doivent transiter de la mémoire vers les unités de calcul pour un seul mot. Maintenir un rythme de 100 tok/s impose ainsi un débit critique de 500 Go par seconde.
C’est ici que se dessine la véritable hiérarchie du matériel :
- Les GPU dédiés haut de gamme : Portés par de la mémoire GDDR7 ultra-rapide et des bus de large dimension (jusqu’à 512 bits sur la RTX 5090), ils dépassent le seuil d'1 To/s, autorisant des débits supérieurs à 150 tok/s.
- Les architectures à mémoire unifiée (Apple M4 Ultra, Nvidia GB10, AMD Strix Halo) : En associant la proximité physique de la RAM et du processeur, elles affichent des bandes passantes de 250 à 800 Go/s, s’affranchissant des goulets d’étranglement pour exécuter des modèles massifs (70B) avec efficacité.
- Le recours à la RAM système (GGUF sur CPU) : Une solution de repli pénalisante. Même adossée à une mémoire DDR5 bicanal, la bande passante plafonne entre 50 et 100 Go/s. Dès que la VRAM s’avère insuffisante et que le modèle bascule sur la mémoire centrale, les performances chutent drastiquement, ralentissant considérablement les échanges.
L’Écosystème Logiciel et le Fossé Technologique
L’architecture matérielle ne s’exprime qu’à travers l’intermédiation des couches logicielles. La position dominante historique de Nvidia ne repose pas seulement sur les performances de ses cœurs CUDA, mais sur la robustesse de son écosystème. Face à elle, l’intégration des cartes AMD sous Windows met en lumière la complexité des couches de calcul GPGPU : alors que ROCm nécessite des procédures d’installation spécifiques, l’API Vulkan sert souvent d’alternative pour exploiter directement les GPU concurrents.
De plus, le mécanisme d’offloading (le déchargement partiel des couches neuronales vers la RAM système en cas de saturation de la VRAM) met en évidence les limites d’un dimensionnement insuffisant. Entre la taille brute du modèle, l’espace requis pour la fenêtre de contexte (le KV Cache, dont la consommation augmente proportionnellement avec la longueur de la conversation) et les ressources consommées par le système d’exploitation, l’espace disponible se restreint rapidement.
La Bifurcation Stratégique : Entre IA « Réflexe » et IA « Cerveau »
L’analyse comparative de ces configurations conduit à un constat technique clair : le choix du matériel n’est pas dicté par la recherche de la vitesse absolue, mais par la nature des charges de travail et la complexité des traitements attendus.
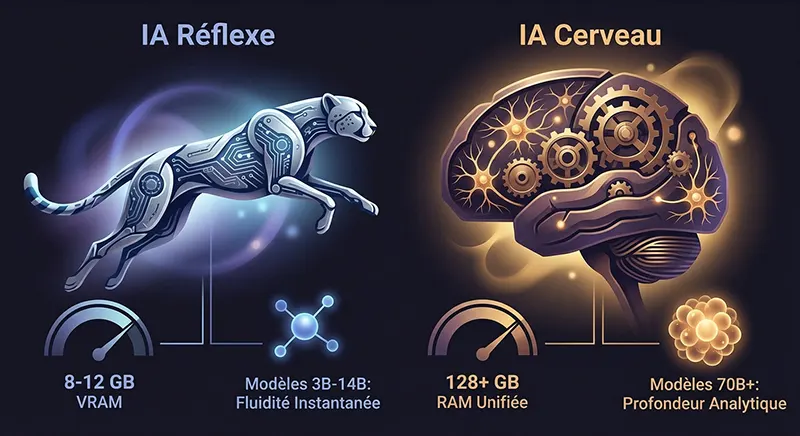
- L’IA « Réflexe » (Modèles légers de 3B à 14B) : Conçus pour l’efficience, ces modèles privilégient la rapidité d’exécution. Animés par une configuration modeste (8 à 12 Go de VRAM), ils répondent instantanément, convenant parfaitement au traitement rapide de courriels, à l’analyse de code ou à la recherche documentaire ciblée.
- L’IA « Cerveau » (Modèles lourds de 70B à 400B) : Ce segment relève de l’analyse approfondie, du raisonnement complexe et de la génération de structures documentaires avancées. Leur déploiement nécessite des ressources importantes — stations multi-GPU ou architectures à mémoire unifiée — où le volume de traitement prime sur la vitesse immédiate. Le système privilégie alors la profondeur de calcul à la simple réactivité.
En définitive, concevoir une station d’intelligence artificielle locale exige une adéquation rigoureuse entre les spécifications techniques et les besoins opérationnels. La puissance de calcul brute ne suffit pas sans une architecture de bus adaptée ; le silicium, sans une mémoire performante, ne peut exprimer son plein potentiel.
La Révolution de l’IA Locale : Analyse Comparative des Mini-PC GMKtec et des Architectures d’Inférence Souveraines
L’écosystème du traitement automatique du langage naturel et de l’intelligence artificielle générative connaît une mutation structurelle profonde. L’hégémonie des architectures distantes dans le cloud, pénalisées par des coûts d’API récurrents, des latences variables et des impératifs de confidentialité, cède la place à l’émergence d’une infrastructure locale décentralisée. Dans ce paradigme d’autonomie, le constructeur GMKtec s’impose comme un acteur clé, capable de condenser une puissance d’inférence autrefois réservée aux centres de données dans des boîtiers compacts à faible consommation énergétique.
L’évaluation technique des performances matérielles permet de structurer une hiérarchie précise des configurations, étalonnée selon les exigences d’inférence des grands modèles de langage (Large Language Models ou LLM) et l’exécution de processus automatisés continus.
Panorama Systémique : Cartographie des Matériels d’Inférence
L’efficacité d’un système d’intelligence artificielle locale repose sur l’équilibre entre la fréquence processeur, la bande passante de la mémoire et la capacité d’accélération neuronale intégrée (Neural Processing Unit ou NPU). Les stations de travail compactes GMKtec se répartissent en trois catégories d’infrastructure distinctes.
1. Le Palier Souverain “Ultra-Pro” (Inférence des Modèles Lourdement Quantisés et LLM Géants)
Ces stations de calcul représentent l’état de l’art technique. Conçues pour l’exécution d’agents autonomes et le déploiement de modèles dépassant 70 milliards de paramètres, elles rivalisent avec les serveurs traditionnels.
| Référence du Modèle | Architecture Processeur & Cœurs | Mémoire Unifiée & Bande Passante | Capacités d’Inférence & Modèles Cibles |
|---|---|---|---|
| GMKtec EVO-X2 | AMD Ryzen™ AI Max+ 395 (16C / 32T, TSMC 4nm, 5.1 GHz, TDP 120W-140W) | 64 Go ou 128 Go LPDDR5X (8000/8533 MHz, 8 canaux) | Référence en inférence locale. 126 TOPS globaux, NPU XDNA 2. Exécute DeepSeek-R1 (70B), Llama 4 (109B) et Qwen3 (235B) avec une stabilité optimale. |
| GMKtec EVO-X3 | AMD Ryzen™ AI Max+ 395 (16C / 32T, architecture Zen 5) | 128 Go LPDDR5X (8000 MT/s) & Double M.2 PCIe 4.0 | Conçu pour la persistance des données. Inférence à haut débit et prise en charge de bases vectorielles locales de grande capacité. |
| Série Intel EVO-T1 / T2 | Intel Core Ultra X9 / Ultra 9 285H (16 cœurs, jusqu’à 180 TOPS globaux) | 64 Go LPDDR5X, carte graphique Arc B390 intégrée | Intégration optimisée avec les outils d’optimisation OpenVINO. Adapté à l’analyse multimodale et au traitement d’images. |
2. Le Palier Prosumer et Intermédiaire (Traitement de Données & Inférence Média)
Ce segment offre un équilibre optimal entre coût et performance. Ces configurations exécutent des modèles intermédiaires tout en gérant les applications exigeantes (MAO, montage vidéo et analyse sémantique).
| Référence du Modèle | Architecture Processeur & Cœurs | Mémoire & Extensibilité | Capacités d’Inférence & Modèles Cibles |
|---|---|---|---|
| GMKtec EVO-X1 | AMD Ryzen™ AI 9 HX 370 (12C / 24T, Zen 5) | 32 Go LPDDR5X (7500 MHz), connecteur OCuLink | Inférence à faible latence sur des modèles de 14B à 32B. Possibilité d’extension via GPU externe en OCuLink. |
| NucBox K11 | AMD Ryzen 9 8945HS (8C / 16T) | Architecture extensible DDR5 | Adapté au traitement de flux parallèles, au scraping intensif et à la vectorisation documentaire. |
| NucBox K8 Plus / K6 / K12 | AMD Ryzen 7 8845HS / 7840HS (8C / 16T) | 32 Go RAM DDR5, architecture multi-slots M.2 | Efficacité opérationnelle. Puce graphique Radeon 780M, bonne gestion thermique et niveau sonore réduit. |
| NucBox K10 | Intel Core i9-13900HK (14 cœurs / 20 threads) | Architecture extensible DDR5 | Puissance de calcul élevée en monothread et multithread, recommandée pour l’exécution d’agents IA. |
3. Le Palier d’Entrée Opérationnel (Automatisations Continuelles & Modèles Légers)
Destinées aux environnements applicatifs plus restreints, ces configurations assurent l’exécution de flux de collecte, de filtrage et d’analyse sémantique basique.
| Référence du Modèle | Architecture Processeur & Cœurs | Mémoire & Configuration Stockage | Capacités d’Inférence & Modèles Cibles |
|---|---|---|---|
| K13 | Intel Core Ultra 7 256V | Intégrée, haute efficacité énergétique | Adapté aux tâches de filtrage, à la génération de métadonnées et à l’exécution de modèles 7B. |
| NucBox M3 Ultra | Intel Core i7-12700H (14 cœurs / 20 threads) | 32 Go DDR4 / Double emplacement M.2 + SATA 2.5" | Polyvalence matérielle. Compatibilité avec des disques SATA 2.5 pouces pour le stockage de volumes de données importants. |
| M7 Ultra | AMD Ryzen™ 7 PRO 6850U (8C / 16T) | 32 Go DDR5 / SSD PCIe 3.0 | Stabilité orientée professionnelle et consommation maîtrisée pour un fonctionnement continu 24h/24. |
Focus Technique : La Station d’Inférence GMKtec EVO-X2
L’analyse détaillée du modèle GMKtec EVO-X2 met en évidence l’intégration d’architectures système sur puce (SoC) avancées. Le processeur AMD Ryzen™ AI Max+ 395, gravé en 4 nm par TSMC, associe 16 cœurs physiques au circuit graphique Radeon 8060S sous architecture RDNA 3.5.
+-----------------------------------------------------------------------+
|                         GMKtec EVO-X2 ARCHITECTURE                     |
|                                                                       |
|  +-----------------------------------------------------------------+  |
|  | AMD Ryzen AI Max+ 395 (16 Cœurs / 32 Threads - Zen 5)           |  |
|  +-----------------------------------------------------------------+  |
|  | NPU XDNA 2 (50 TOPS)  |  GPU Radeon 8060S (40 CUs RDNA 3.5)      |  |
|  +-----------------------+-----------------------------------------+  |
|                                                                       |
|  +-----------------------------------------------------------------+  |
|  | Bus Mémoire Unifiée LPDDR5X-8533 (8 Canaux - Jusqu'à 128 Go)     |  |
|  +-----------------------------------------------------------------+  |
|                                                                       |
|  +-----------------------------------------------------------------+  |
|  | Stockage NVMe PCIe 4.0 x4 (2x Emplacements M.2 - Jusqu'à 16 To)   |  |
|  +-----------------------------------------------------------------+  |
+-----------------------------------------------------------------------+
Spécifications Systèmes Détaillées du GMKtec EVO-X2
- Processeur (CPU) : AMD Ryzen™ AI Max+ 395, 16 cœurs, 32 threads, fréquence maximale de 5,1 GHz, 80 Mo de cache combiné (L2+L3), TDP configurable de 45W à 140W.
- Processeur Graphique (GPU) : AMD Radeon™ 8060S, 40 unités de calcul (CU) basées sur l’architecture RDNA 3.5, offrant des performances de traitement graphique et de calcul élevées.
- Accélérateur IA (NPU) : Architecture AMD XDNA 2 délivrant 50 TOPS dédiés, portant la puissance globale de la plateforme à 126 TOPS.
- Sous-système Mémoire : Jusqu’à 128 Go de mémoire LPDDR5X à 8533 MHz sur un bus 8 canaux, assurant un débit adapté au chargement des modèles.
- Stockage Secondaire : Double emplacement M.2 2280 NVMe PCIe 4.0 x4, supportant une capacité totale de 16 To.
- Connectivité Réseau & E/S : Wi-Fi 7 (RZ717), Bluetooth 5.4, contrôleur Ethernet 2.5 Gigabit (Realtek 8125BG), ports USB4 Type-C (40 Gbps), HDMI 2.1 et DisplayPort 1.4.
Analyse des Performances d’Inférence en Environnement Local
La vitesse d’exécution d’un modèle de langage se mesure par la latence du premier jeton (Time to First Token ou TTFT) et le débit de génération exprimé en tokens par seconde (t/s). Les tests d’inférence menés sur le système GMKtec EVO-X2 (128 Go LPDDR5X) valident l’efficacité du traitement local pour des modèles complexes.
Métriques d’Inférence Observées sur l’EVO-X2 (128 Go)
- Qwen3 (235B Parameters) : Temps du premier jeton à 0,03 s, vitesse moyenne de 11,00 t/s.
- Llama 4 (109B-Q4KM) : Temps du premier jeton à 0,02 s, vitesse moyenne de 13,83 t/s.
- OpenAI GPT-OSS (120B) : Temps du premier jeton à 0,53 s, vitesse moyenne de 19,25 t/s.
- Qwen3 (30B) : Temps du premier jeton à 0,18 s, vitesse moyenne de 55,02 t/s.
- DeepSeek-R1 (32B) : Temps du premier jeton à 10,50 s, vitesse moyenne de 9,26 t/s.
Optimisation de l’Infrastructure d’Automatisation SEO et Média
L’intégration d’un Mini-PC GMKtec au sein d’un environnement de production numérique permet de structurer une architecture d’automatisation continue à coût d’exploitation minimal.
+-----------------------------------------------------------------------+
|                   AUTOMATISATION EN INFRASTRUCTURE LOCALE             |
|                                                                       |
|  [Étape 1 : Collecte & Scraping H24]                                  |
|         |---> Scripts Python / Playwright (Exécution multi-cœurs)     |
|         v                                                             |
|  [Étape 2 : Orchestration Sémantique]                                 |
|         |---> Plateforme n8n (Workflows locaux automatisés)           |
|         v                                                             |
|  [Étape 3 : Inférence & Synthèse par IA Locale]                       |
|         |---> Ollama / LM Studio (Modèles DeepSeek, Qwen, Llama)      |
|         v                                                             |
|  [Étape 4 : Déploiement & Indexation SEO]                             |
|         |---> Publication API & Génération d'images uniques           |
+-----------------------------------------------------------------------+
Principes d’Amélioration de la Productivité Éditoriale
- Suppression Totale des Coûts d’API : L’exécution des modèles de traitement sémantique en local élimine la facturation liée à l’utilisation de services distants. L’investissement matériel est ainsi rapidement amorti.
- Collecte et Analyse Continuelles : Les cœurs à haute efficacité énergétique gèrent l’aspiration des flux d’actualités, la surveillance de la concurrence et l’analyse syntaxique sans impacter les performances globales du système.
- Souveraineté des Données et Confidentialité : L’absence de transfert vers des serveurs tiers garantit la protection stricte de la propriété intellectuelle, des bases de connaissances internes et des stratégies de contenu avant publication.
- Efficacité Énergétique : Avec une consommation stabilisée entre 15W et 45W en charge applicative moyenne, l’empreinte énergétique et les coûts d’exploitation demeurent réduits par rapport à une infrastructure serveur classique.
En somme, la gamme de Mini-PC GMKtec propose des solutions adaptées aux exigences de calcul moderne. De la polyvalence des stations M3 Ultra ou K8 Plus pour la gestion opérationnelle quotidienne jusqu’à la puissance de calcul souveraine délivrée par la série EVO-X2, ces équipements constituent une alternative crédible pour le déploiement d’infrastructures informatiques indépendantes.
Cet article est rédigé par Blaise Grenier, Journaliste reporter d'images et auteur. Découvrir le parcours de l'auteur et la charte éditoriale »