Souveraineté Numérique et Inférence Embarquée : Plongée au Cœur des LLM Locaux
L’intelligence artificielle générative a cessé d’être une simple curiosité académique pour devenir un composant structurel de l’infrastructure informatique moderne. Tandis que le grand public délègue ses requêtes à des infrastructures distantes à grand renfort d’abonnements, une frange croissante d’utilisateurs exigeants et de professionnels explore une alternative radicale : l’hébergement et l’exécution de modèles de langage (LLM) directement sur leur propre matériel. Cette démarche, loin de relever du simple gadget technique, redéfinit le rapport de l’utilisateur à sa machine, le transformant de simple locataire de services infonuagiques en propriétaire souverain de son outil de calcul.
Les Fondements Techniques : De la Probabilité à l’Inférence
Pour appréhender la mise en place d’un environnement d’IA local, il est impératif de déconstruire le mythe d’une machine pensante. Un LLM ne « comprend » pas le texte au sens humain du terme ; il s’agit d’un système de deep learning fondé sur des calculs probabilistes massifs.
Le Modèle et ses Paramètres
Le nombre de paramètres — désigné par la nomenclature courante (8B, 70B, etc.) — représente l’équivalent synthétique des synapses biologiques. Ces matrices de poids, affinées lors de phases d’entraînement menées sur des clusters de supercalculateurs, dictent la réactivité et la finesse de raisonnement du modèle. Plus ce volume est élevé, plus le réseau de neurones artificiels gère de nuances contextuelles, mais plus l’empreinte en mémoire vive s’alourdit.
Le Token, Unité de Mesure Fondamentale
Le texte n’est jamais traité de manière globale, mais découpé en fragments d’unités lexicales ou syntaxiques nommées tokens. En français, un millier de tokens représente schématiquement sept cent cinquante mots. Lors de la phase d’inférence — le moment critique où le matériel génère la réponse en temps réel — chaque token produit exige un balayage complet des paramètres du modèle à travers la bande passante de la mémoire. C’est précisément pour cette raison que la performance d’un système local se mesure en tokens par seconde ($\text{tok/s}$).
La Quantification : L’Art du Compromis
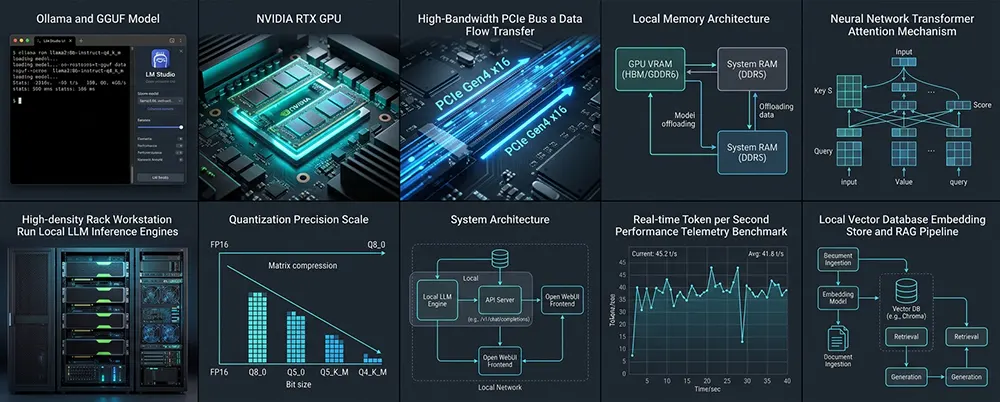
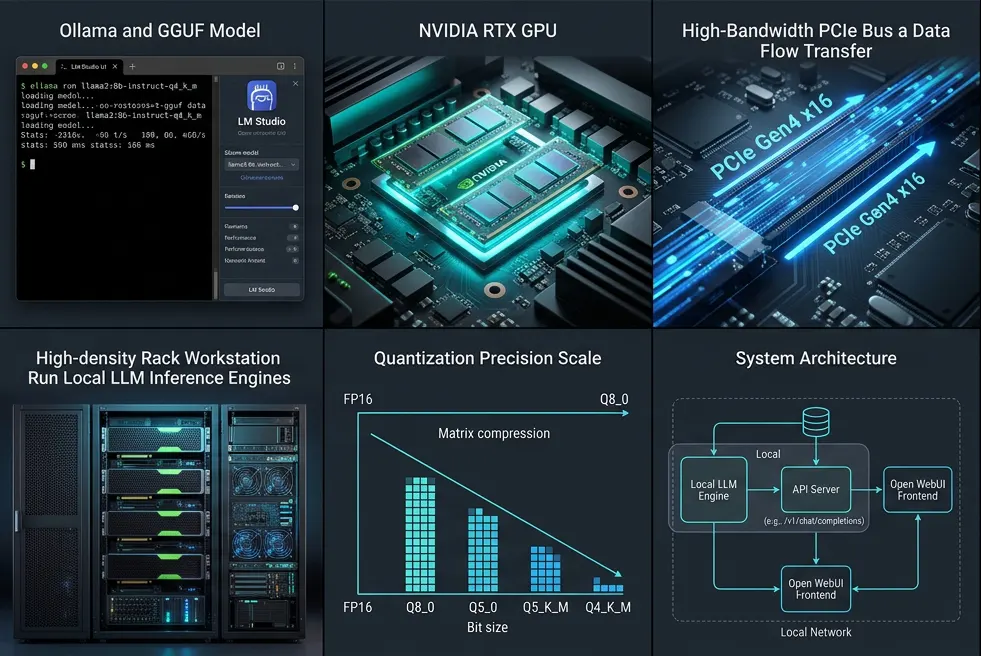
À l’état brut (en précision FP16), un modèle de taille critique exigerait des volumes de VRAM inaccessibles au grand public. La quantification résout cette équation en compressant la précision numérique des paramètres (par exemple, en passant à des formats 4 bits comme Q4_K_M). Cette compression drastique permet de faire tenir des modèles d’envergure sur des configurations matérielles standard, moyennant une perte infinitésimale de finesse logique.
Cloud versus Local : Arbitrage Stratégique
L’opposition entre les solutions distantes et l’inférence locale ne relève pas d’une simple guerre de benchmarks, mais d’un choix architectural fondamental.
| Critères d’Évaluation | Écosystème Cloud Propriétaire | Inférence Locale (Open Weights) |
|---|---|---|
| Souveraineté des Données | Transit et stockage sur serveurs tiers | Confidentialité absolue, traitement 100 % local |
| Disponibilité | Dépendance totale au réseau et aux pannes | Autonomie opérationnelle permanente hors-ligne |
| Modération & Filtres | Contraintes éditoriales et politiques strictes | Liberté d’usage totale, absence de censure arbitraire |
| Modèle Économique | Abonnements récurrents, monétisation des données | Coût marginal nul après amortissement matériel |
| Capacité Brute | Modèles XXL (centaines de milliards / billions) | Limité par la VRAM/RAM de la machine hôte |
Pour les professionnels manipulant des données hautement sensibles — qu’il s’agisse de cabinets juridiques ou de services de rétro-ingénierie logicielle — le passage au local n’est pas une option, mais une exigence de conformité.
Anatomie d’un Banc d’Essai : Dimensionnement Matériel
L’évaluation empirique des besoins matériels impose de dépasser les idées reçues. Contrairement aux charges de travail graphiques traditionnelles, l’inférence de LLM met la mémoire vidéo (VRAM) au centre du jeu, reléguant le GPU au rang de simple exécutant des calculs matriciels.
Typologie des Configurations Testées
- Entrée de gamme : Processeur Core i5 associé à une carte graphique dotée d’un bus mémoire suffisant (minimum syndical de 8 Go de VRAM pour amorcer l’exécution de petits modèles).
- Workstations spécialisées : Associations de processeurs multicœurs récents et de cartes graphiques haut de gamme (type architectures équipées de larges pools de mémoire rapide).
- Architectures unifiées : Systèmes sur puce (SoC) combinant des volumes de mémoire unifiée élevés (de 128 Go et au-delà), permettant de sranchir les limites traditionnelles de la VRAM dédiée.
La Hiérarchie des Ressources
- La VRAM (Mémoire Vidéo) : Facteur limitant absolu. Si le modèle et son cache de contexte (KV Cache) ne logent pas intégralement dans la mémoire de la carte graphique, le système doit basculer sur la RAM système via le bus PCIe, effondrant instantanément les débits d’inférence.
- La RAM Système & Largeur de Bande : Indispensable pour les architectures unifiées ou pour l’exécution par délestage (CPU offloading), bien que nettement plus lente que la HBM ou la GDDR6.
- Le Stockage NVMe : Sollicité au chargement initial des fichiers de modèles (souvent de plusieurs dizaines de gigaoctets au format GGUF).
Typologie des Modèles et Scénarios d’Usage
Le choix de l’architecture de modèle dépend directement de la complexité de la tâche assignée. On distingue schématiquement trois grandes catégories d’usage opérationnel :
1. Le Scénario Créatif (Modèles compacts, ex. Phi-4 Mini, Llama 3.1 8B)
Idéal pour la génération de contenus textuels fluides, la traduction rapide ou l’idéation marketing. Ces modèles réactifs consomment peu de ressources et s’exécutent avec un grand confort sur des stations de milieu de gamme.
2. Le Scénario Analyste (Modèles intermédiaires, ex. Mistral Small, Llama 3.3)
Conçu pour la synthèse de documents denses, l’extraction structurée de données issues de rapports techniques ou le traitement par lot de corpus documentaires. Leur fenêtre de contexte élargie (souvent poussée à 32k ou 128k tokens) exige une surveillance accrue de la saturation du cache KV.
3. Le Scénario Expert (Modèles de raisonnement / Thinking)
Inspirés par les paradigmes de type chaîne de pensée (Chain of Thought), ces modèles (tels que les déclinaisons orientées mathématiques ou code) génèrent une phase de réflexion intermédiaire invisible avant de délivrer leur verdict. Si leur rigueur logique est redoutable pour déboguer du code source ou résoudre des équations complexes, cette phase de calcul interne monopolise durablement les ressources de calcul.
L’Alternative Spécialisée : Le NLP Classique face aux LLM
Il serait erroné de réduire le traitement automatique des langues aux seuls modèles génératifs géants. Dans de nombreux cas industriels, le recours aux architectures NLP (Natural Language Processing) traditionnelles s’avère infiniment plus pertinent :
- Précision chirurgicale : Des tâches spécifiques comme la reconnaissance d’entités nommées (NER) ou l’extraction univoque de valeurs numériques dans des factures sont exécutées par des modèles compacts avec une fiabilité supérieure et un taux d’hallucination quasi nul.
- Efficience énergétique : Un modèle NLP spécialisé s’exécute quasi instantanément sur un simple processeur (CPU), éliminant la surchauffe et la consommation électrique disproportionnée d’un GPU mobilisé pour un LLM généraliste.
Conclusion et Perspectives
L’appropriation de l’intelligence artificielle par la voie locale marque la transition d’une ère d’assistanat numérique centralisé vers une informatique d’émancipation. Si les géants du cloud conservent l’avantage de la puissance brute pour les tâches multimodales d’envergure planétaire, le poste de travail individuel s’affirme désormais comme un nœud de calcul autonome, garantissant aux utilisateurs la maîtrise absolue de leurs données et de leurs outils.
Cet article est rédigé par Blaise Grenier, Journaliste reporter d'images et auteur. Découvrir le parcours de l'auteur et la charte éditoriale »